スーパーの店舗分布を二点相関関数で測る
2026-11-14:ノートの改訂(コスモスと Walmart の追加、結果を問いごとに組み直したこと)に合わせて、この記事を書き直しました。
先に結論
宇宙論で銀河がどれだけ集まっているかを測る道具(二点相関関数)を、スーパーとドラッグストアの店舗の座標に当てました。 比べたのは、オーストラリアの Coles と Woolworths、日本のトライアル・西友・コスモス、米国の Walmart です。 結果は三つの問いに分けて読めます。
- 人口で説明できるか:Coles と Woolworths の並び方は、人口の分布でほぼ説明できます。トライアル、コスモス、Walmart は人の密集地に店が少なく、西友は逆に多い。ただし、この違いの大半は「どの地方に出店しているか」の偏りです。
- 出店している地方を差し引いても固まるか:トライアルの店は 3–25 km の距離で互いに固まっています。西友は 8 km より短い距離で強く固まります。コスモスの固まりの大半は、地盤の九州の外から来ています。Walmart は数十 km で弱く固まり、数 km では逆に店どうしが離れています。
- 二社の関係:トライアルと西友の店は 8–30 km で互いに離れて並んで見えますが、トライアルの店の置き方で説明でき、二社が互いを避けているとまでは言えません。トライアルとコスモスは、全国では近くに並び、九州の中ではむしろ少し離れて並びます。
全文(式の導出、データの作り方、誤差の見積もり、付録)は PDF にまとめました。
計算(Rust)、図(Python)、ノート(TeX)、式の検証(Lean)は GitHub で公開しています:inuverse44/retail-cosmology
この記事はその概要です。
二点相関関数とは
二点相関関数 は、点がどれだけ集まっているかを距離 ごとに表す量です。 距離 だけ離れた店の組が、店をでたらめに撒いたときより多ければ 、少なければ になります。
組の数を数えるだけでは、海岸線や人口の偏りまで に出てしまいます。 そこで、店と同じ領域に「店どうしに相関がなかったら、店はどこにあるはずか」を表す点(ランダムカタログ)を撒いて比べます。 比べ方には Landy と Szalay の推定量を使いました。 推定量の計算は以前の記事 Landy-Szalay推定量①、Landy-Szalay推定量② にまとめています。
どんな基準と比べるかで、 に何が出るかが変わります。 このノートでは、人口に比例して撒いた点を基準にしました。 こうすると、人が住んでいる所に店があるという当たり前の分は消え、それを超えて店が固まるか、間隔をあけて並ぶかが残ります。 さらに、チェーンが一部の地方にしか出店していない分も、選択関数として基準に入れました。
同じ道具は、空間統計学では別の名前で知られています。 二点相関関数に 1 を足したものが対相関関数で、その積分が Ripley の K 関数です。人口を基準にするのは非一様な K 関数に、二社の相互相関は cross-K 関数に当たります。 経済地理学では、Duranton と Overman(2005)が事業所の間の距離を、無作為に選んだ模擬データと比べて業種の集積を判定しており、考え方はこのノートとほぼ同じです。
比べたチェーン
トライアルを真ん中に置き、比べる相手を役割で選びました。
| 役割 | チェーン | 国 | 店の数 | 店の座標 |
|---|---|---|---|---|
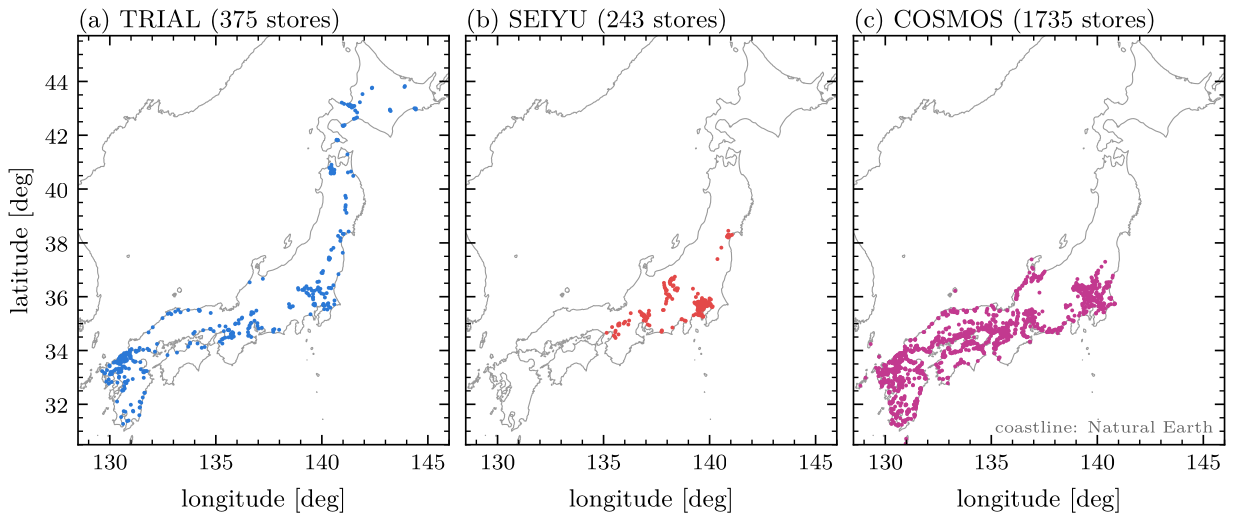
| 基準 | トライアル | 日本 | 375 | 公式サイトの店舗検索 |
| 内側の横(2025 年に子会社にした会社) | 西友 | 日本 | 243 | 公式サイトの店舗検索 |
| 外側の横(九州で地盤が重なる競合) | コスモス(ドラッグストア) | 日本 | 1,735 | 公式サイトの一覧の住所から推定 |
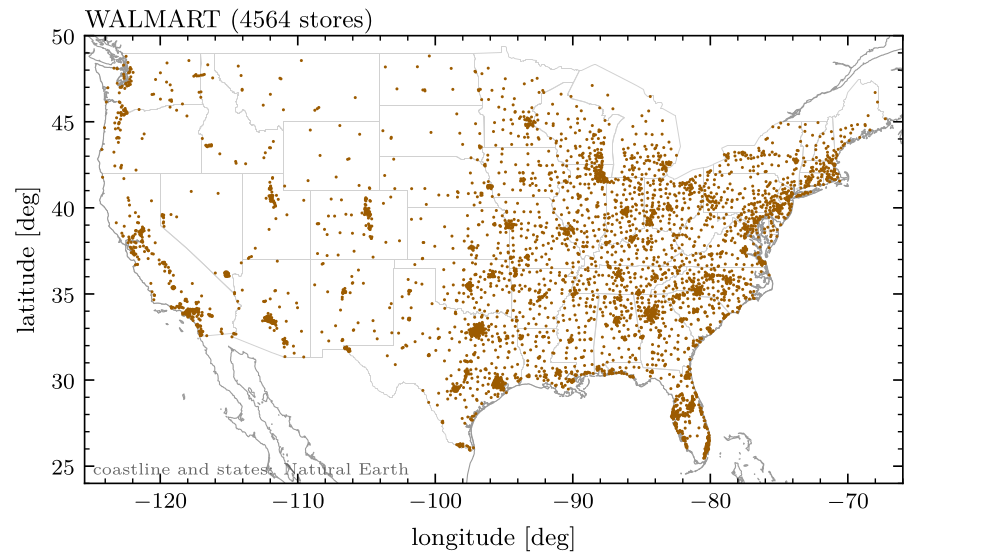
| 世界の大手(世界規模のスーパーセンター) | Walmart | 米国 | 4,564 | OpenStreetMap |
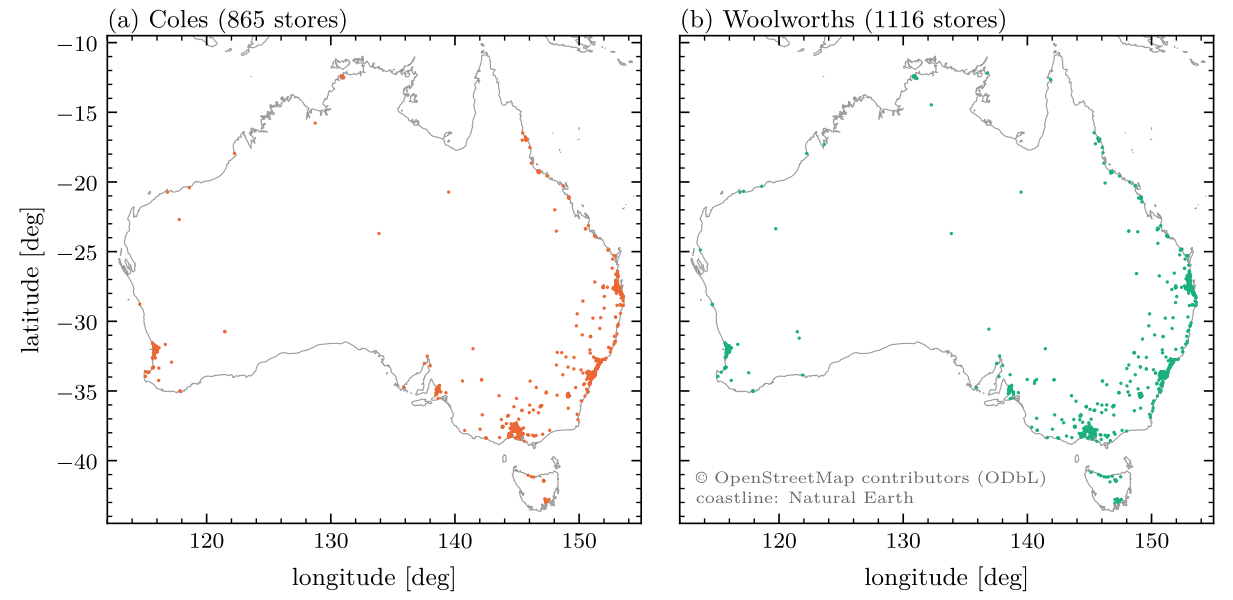
| 市場の構造(二社寡占が進んだ市場) | Coles・Woolworths | オーストラリア | 865・1,116 | OpenStreetMap |
- オーストラリアの店の数は、OpenStreetMap でも決算資料の数の 99% 前後でした。
- 日本の OpenStreetMap ではトライアルの店が 6 割ほど、コスモスは 26% しか見つからなかったので、公式サイトから取りました。コスモスのサイトには座標がないので、住所から国土地理院の住所検索で座標を引きました。
- 米国本土の Walmart は OpenStreetMap から 4,564 店で、本土の外を足すと 10-K の全米の店数の 99.8% になりました。
- 公式サイトから取った店の一覧そのものは、ノートにもこの記事にもリポジトリにも載せていません。
- 人口は、オーストラリア統計局の 1 km 格子、令和 2 年国勢調査の 1 km メッシュ、米国は JRC の GHS-POP(1 km 格子)を使いました。
問い 1:人口で説明できるか
オーストラリア:ほぼ説明できる
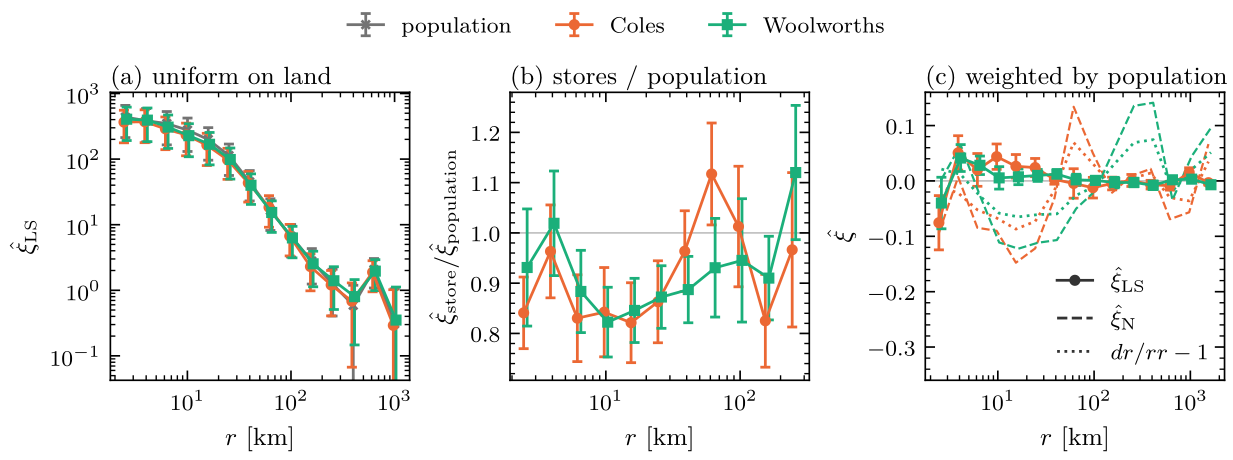
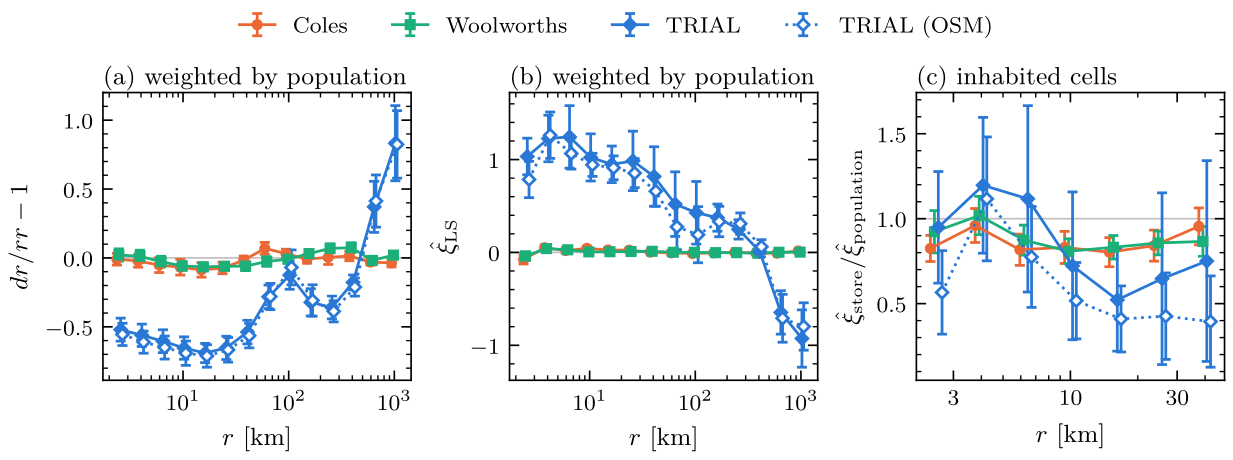
人口に比例する基準と比べると、Coles と Woolworths の は 3 km 以上でほぼ 0 になります(下の図の (c) の実線)。 二社の店の並び方は、人の住み方でほぼ説明できるということです。
もう一つ見るのが です。 店と基準の点の組を、基準の点どうしの組と比べた量で、店が人口に比例して置かれていれば 0、人の密集地に店が少なければ負、多ければ正になります。 Coles と Woolworths はどちらも で、人が密集している所ほど人口あたりの店が少し少ない傾向が、誤差の 1.5–3 倍ほど見えます。
日本と米国:密集地への寄り方がチェーンで違う
(8–50 km)は、チェーンによって大きく違いました。
| チェーン | 読み | |
|---|---|---|
| Coles・Woolworths | ほぼ人口どおり | |
| トライアル | 密集地に少ない(オーストラリアの約 10 倍) | |
| コスモス | トライアルとほぼ同じ | |
| Walmart | 密集地に少ない(約 8 倍) | |
| 西友 | 逆に密集地に多い |
ただし、この違いの大半は「どの地方に出店しているか」です。 トライアルは 375 店のうち 145 店が九州に、西友は 243 店のうち 135 店が関東にあります。 実際、九州の中だけで測ると、トライアルの は と正になり、コスモスは に縮みます。 九州の中では、二社の並び方は人口でほぼ説明できます。
地方の偏りをそろえても密集地への寄り方が残るのは、寄る向きの西友と、避ける向きの Walmart でした。 トライアルは、地方の中では人の多い所を特に避けてはいません。
問い 2:出店している地方を差し引いても固まるか
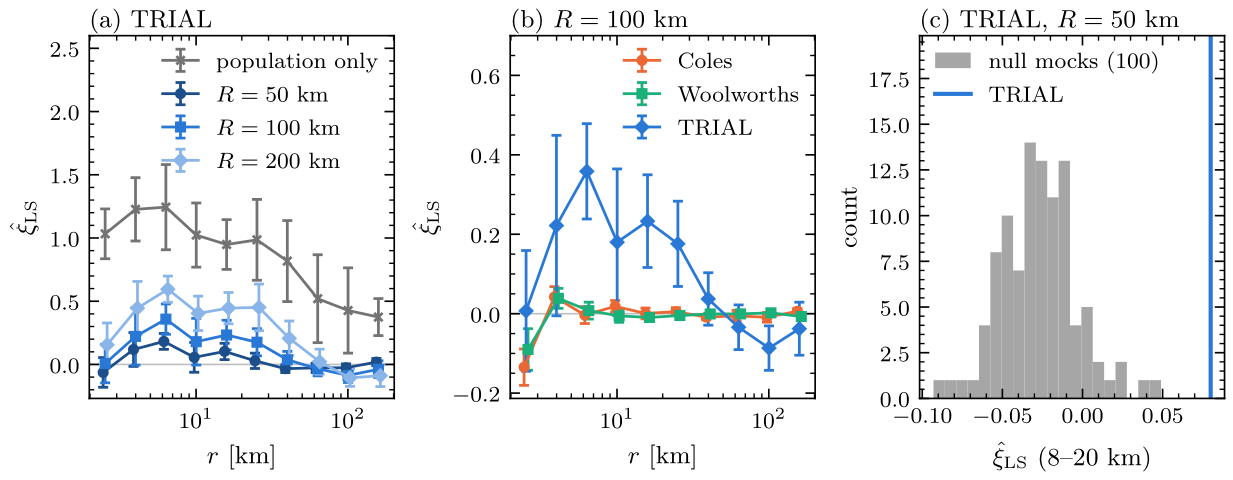
出店している地方を選択関数として基準に入れ、店を選択関数に従って独立に撒き直した模擬データ 100 個と比べました。 人の密集地への寄り方までそろえた模擬データも作りました。 オーストラリアの二社は、選択関数を入れても が 0 と合い、固まりは見えません。
トライアル:3–25 km で固まる
トライアルの店は、地方を差し引いても 3–25 km の距離で互いに固まっています(下の図の (a))。 8–20 km の 2 ビンをまとめた値は 0.080 で、模擬データ 100 個では最大でも 0.049、0.080 に届いたものはありませんでした((c))。 3–8 km でも模擬データのどれも届きませんが、2–3 km では模擬データと合い、それより近くには店を重ねていません。
同じ地域に店を重ねて出す出店の仕方(ドミナント出店)や、大型店を拠点に近くへ小型店の TRIAL GO を置く運営は、この結果と合う説明です。ただし、この解析では確かめていません。
西友:数キロの距離で強く固まる
西友の店は、8 km より短い距離で強く固まっています。 密集地への寄り方までそろえた模擬データと比べても、100 個のどれも届かず、平均から 5.6–7.4σ 離れています。 関東では駅に近い店が多いので、駅どうしの間隔で店が並ぶことが一因と考えられますが、確かめていません。 8 km より長い距離での固まりは、ビンのまとめ方によって読みが変わるので、まだはっきりとは言えません。
コスモス:固まりの大半は九州の外から来る
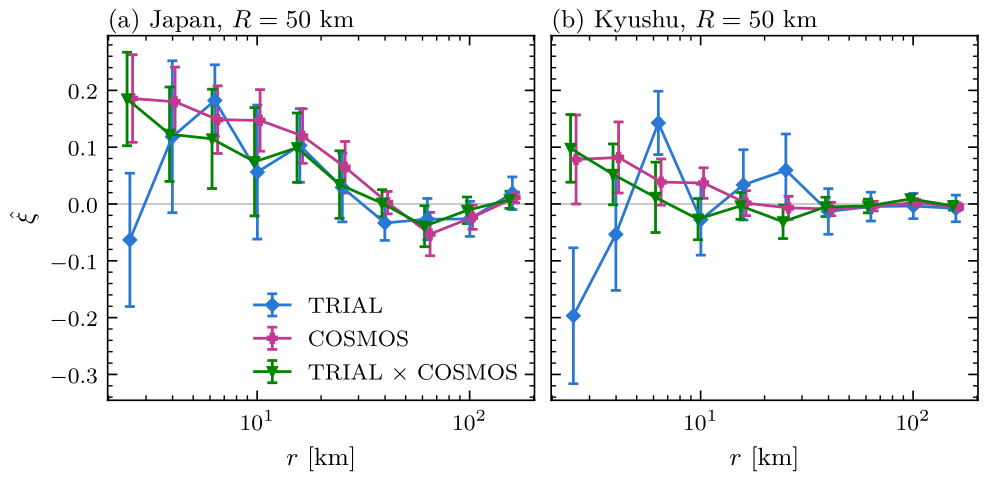
コスモスは、全国で測ると選択関数を入れても強く固まっています(模擬データから 17σ 以上)。 ところが、九州の中だけで測ると固まりの大半が消え、トライアルも同じでした(下の図の (a) と (b))。 九州の外では、二社とも店の少ない地方に新しく出店しています。 新しく出る地方では、出店した市や町の近くに店を重ねていくので、そこで店が固まると考えられます。 店を開いた年は調べていないので、この説明は確かめていません。
Walmart:数十 km で弱く固まり、数 km では離れる
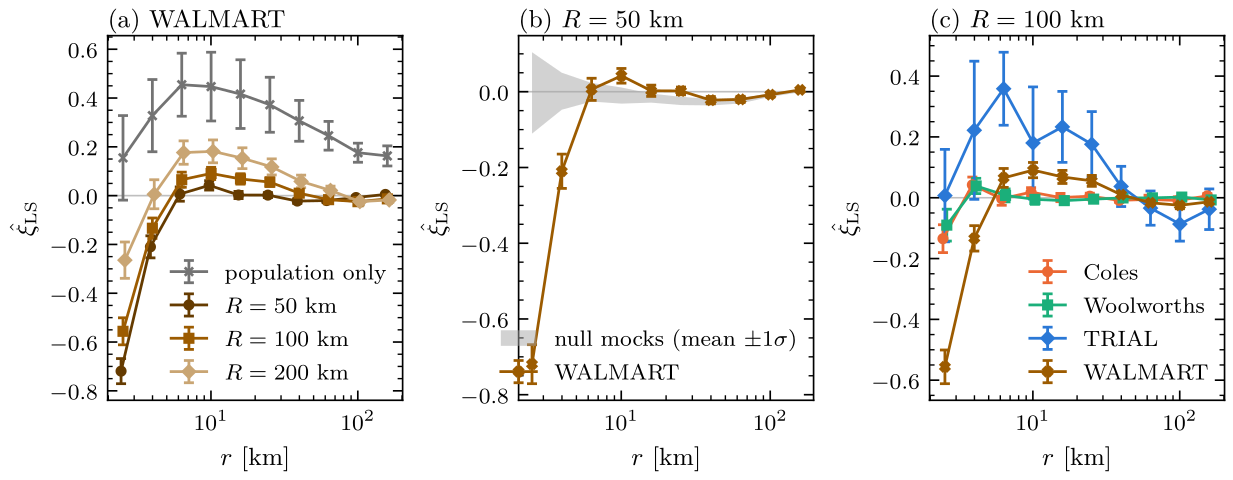
Walmart の店は、8–50 km では弱く固まっています(R = 100 km で、寄り方もそろえた模擬データから 5.0σ)。 一方、8 km より短い距離では逆に店どうしが離れていて、2–3 km のビンは 、模擬データ 100 個のどれよりも小さい値でした。 近くの店どうしが客を奪い合うので、約 5 km より近くには店を置かないようにしていると考えられます。 短い距離で固まるトライアルとは逆です。
この結果は、Walmart の出店を、店が密集することによる配送などの費用の節約と、近くの店どうしの客の奪い合いの釣り合いとして説明した研究(Holmes 2011)と合います。 ただし、物流拠点の位置も開店の年も使っていないので、この説明は確かめていません。
問い 3:二社の関係
トライアルと西友:離れて見えるが、互いを避けてはいない
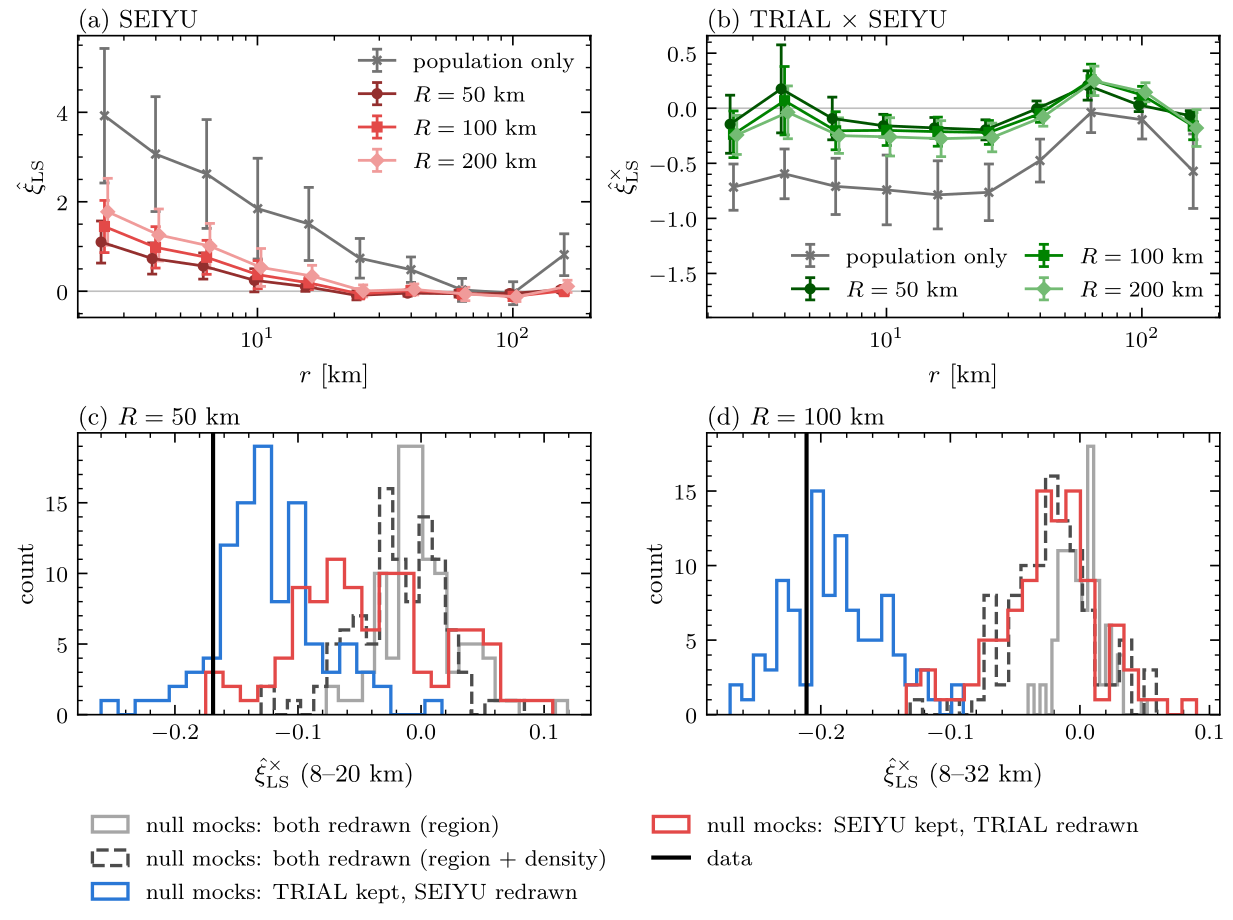
トライアルは 2025 年に西友を子会社にしました。 そこで、二社の店が近くに並ぶか離れて並ぶかを、相互相関関数で調べました。 出店している地方を差し引いても、相互相関は 8–30 km で −0.2 前後と負になります(下の図の (b))。 この距離にある二社の店の組が、地方から見込まれるより 2 割ほど少ないということです。
これだけ見ると二社が互いを避けているようですが、比べる模擬データを変えると読みが変わります((c)(d))。 二社とも撒き直した模擬データ(灰色)では、100 個のどれもこの負の値に届きませんでした。 一方、トライアルの店を実際の位置のまま残し、西友だけを撒き直すと(青)、R = 50 km では 100 個のうち 10 個、R = 100 km では 28 個が実際の値以下になりました。 つまり、負の相互相関はトライアルの実際の店の置き方で説明でき、二社が互いを避けて店を置いていると考える必要はありません。
トライアルとコスモス:全国では近く、九州の中では少し離れる
トライアルとコスモスの相互相関は、全国では正で(模擬データから 8σ 以上)、二社の店は地方から見込まれるより近くに並んでいます。 ところが九州の中だけで測ると、R = 100 km で と負になり、二社の店はむしろ少し離れて並びます(上のコスモスの図)。 全国での正の値は、二社の固まりと同じく、九州の外の新しい出店から来ていると考えられます。
店が数百しかないときの注意
銀河のカタログには何万、何百万という点がありますが、店は数百しかないこともあります。 このくらいの数だと、領域を一つずつ抜いて誤差を見積もる方法(jackknife)の共分散が粗くなり、そこから求めた の上側確率は信用できませんでした。 ノートの模擬データでは、上側確率は場合によって大きくも小さくも出すぎました。 そのため、有意かどうかは 分布ではなく、帰無仮説の模擬データと比べて判断しています。
付録では、データ同士の組の数の分散を、店の数を固定した場合と揺らした場合とで導きました。 人口の濃淡があると、店の数を固定しても分散は大きくなります。Landy–Szalay 推定量ではその分がほぼ打ち消されます。 この導出は Lean 4 と Mathlib で検証しました。
限界
- 比べているのは国ではなくチェーンです。日本の小売全体の並び方を知るには、ほかのチェーンも調べる必要があります。
- データの質がチェーンと国で違います。コスモスの座標は住所から推定し、4 分の 1 ほどは町か字までしか当たりません。米国の店は日付を固定して取り出せず、人口は推計です。人口と店の時期もそろっていません。
- 店が固まる理由(ドミナント出店、TRIAL GO、新しい地方への出店、客の奪い合い)は、この解析からはわかりません。確かめるには、店の業態や開店の年を分けて測る必要があります。
計算と全文
計算は Rust で書き、図は Python で描きました。 全文は PDF に、コードは GitHub にあります。