出たばかりの言語 Goose を、Rust と 3 つの計算で比べてみた
2026 年 10 月に、Goose という新しいプログラミング言語が公開されました。「ヒープも GC もないのにメモリー安全で、C++ や Rust より速い」と書いてあって、気になったので試してみました。
普段は Rust を書いているので、同じ計算を Rust でも書いて比べています。結果は「速いところもあるし、遅いところもある。そして差の理由は、思っていたのと違う場所にあった」でした。
計測の条件、プログラムの設計、途中で間違えたところ、機械語の比べ方まで書きます。
作業は AI(Claude Code)と一緒に進めています。数字はすべて手元で実際に動かした結果です。コードと計測の記録(英語)は GitHub の goose-lab に置きました。
Goose ってどんな言語?
Lobster という言語の作者 Wouter van Oortmerssen さんが作った、システムプログラミング向けの言語です。書き方は C や Rust に近いですが、いちばんの特徴はメモリーの持ち方です。
- ヒープがなく、malloc も GC も参照カウントもありません。
- メモリーは「データスタック」と呼ばれる、ポインターを進めるだけの領域です。スコープを抜けると、ポインターを戻すだけで解放が終わります。
- 文字列や配列を含む構造体も、中身ごと 1 つの塊に詰めて置きます(可変長のフィールドを、レコードの中にそのまま並べます)。
- スレッドはメモリーを共有しません。値は、型ごとに 1 本ある「キュー」で、コピーとして受け渡します。
- コンパイラーは C を生成し、clang でネイティブのコードにします(
goose buildは-O2)。
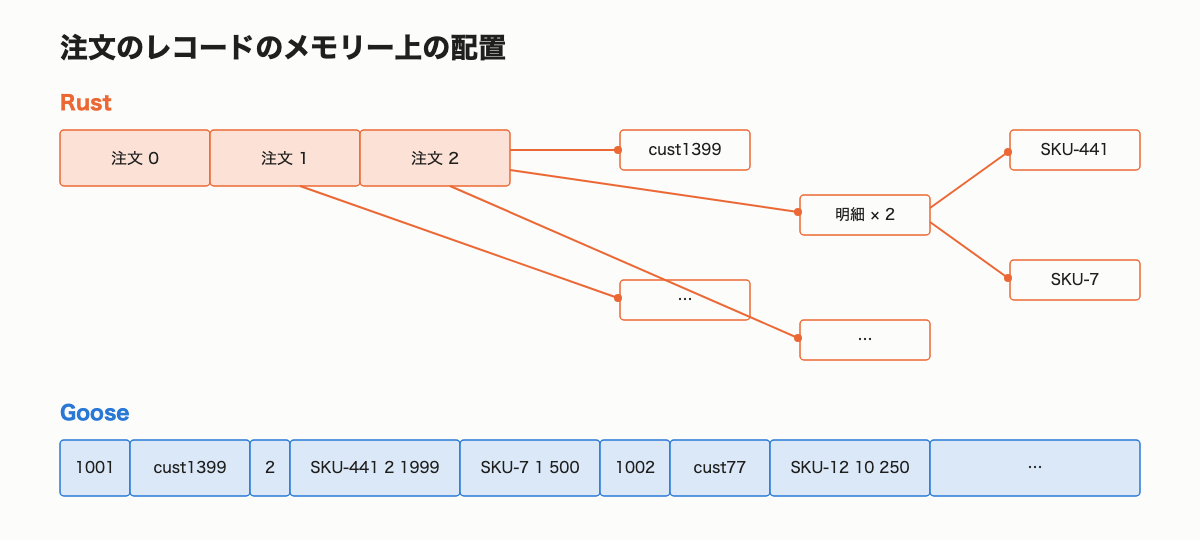
上が Rust、下が Goose です。Rust では注文ごとに名前・明細・商品名を別々の場所に確保して、ポインター(矢印)でつなぎます。Goose では、全部の注文が 1 つの塊に隙間なく並び、ポインターも、1 件ずつの確保もありません。
作者自身の計測では、慣用的な C++ の約 3.5 倍、最速の安全な Rust の約 1.15 倍速く、メモリーも少ないそうです(16 個のベンチマークの平均、作者のサイトより)。
もう 1 つ驚いたのは、README に「このリポジトリは、人間の言語設計をもとに、ほぼすべて AI で作った」と書いてあることです。言語の設計は人間、コンパイラーの実装は AI、という分担だそうです。
試した環境
- Apple M1(高性能コア 4・高効率コア 4、メモリー 8 GB)、macOS 26.6
- Goose v2026.3。
goose buildは Apple clang 21 を-O2で呼びます(--dry-runで確かめました) - Rust 1.99.0。
cargo build --release(opt-level 3、LTO なし) - 時間はプログラムの中の単調な時計で区間ごとに、メモリーの最大(最大 RSS)と命令数・サイクル数は
/usr/bin/time -lで測りました - 実行は 2 つの言語を交互に(ラウンドロビンで)回し、最良値と中央値を出しています
比べたこと 1:注文データの集計
まずは、Goose が得意なはずの計算です。Goose のサンプル samples/16_records.goose(顧客と、商品つきの明細を持つ注文)の形を大きくしました。
- 生成:100 万件の注文を CSV の文字列として 1 つのバッファーに作ります。1 行が 1 件で、
id,cust<k>,SKU-<s>:<数量>:<金額>;...の形です。顧客は 10 万通り、明細は 1〜5 個、商品は 1 万通りです。 - 解析:行と項目に分け、整数を読み、レコードを作ります。
- 集計:顧客ごとの合計金額と、商品ごとの数量を、レコードの中の文字列をキーにしたハッシュ表で数えます。
乱数は、どちらの言語にも同じ splitmix64 を書いて、同じ入力を作っています。結果の行(件数、合計、いちばん買った顧客と、いちばん売れた商品)は両方の言語で同じになるはずで、計測のスクリプトが毎回照らし合わせます。照らし合わせの部分は、わざと 1 行変えた出力を検出できることを先に確かめました。
Rust で素直に書くと、注文 1 件ごとに「名前の String」「明細の Vec」「商品名の String」を別々に確保します。100 万件で約 500 万回のメモリー確保です。Goose では、これが全部 1 つの塊に詰まります。
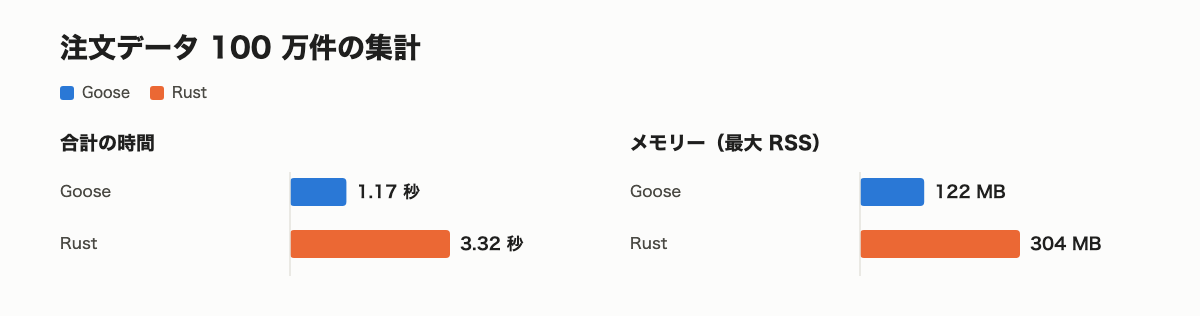
約 2.8 倍速く、メモリーは約 2.5 分の 1 でした(どちらも 7 回の中央値、事前に 2 回空回し)。区間ごとの中央値は次のとおりです。
- 生成:Goose 0.181 秒、Rust 0.577 秒
- 解析:Goose 0.486 秒、Rust 1.477 秒
- 集計:Goose 0.506 秒、Rust 0.786 秒
どの区間でも Goose の方が速く、集計の結果は完全に一致しました。
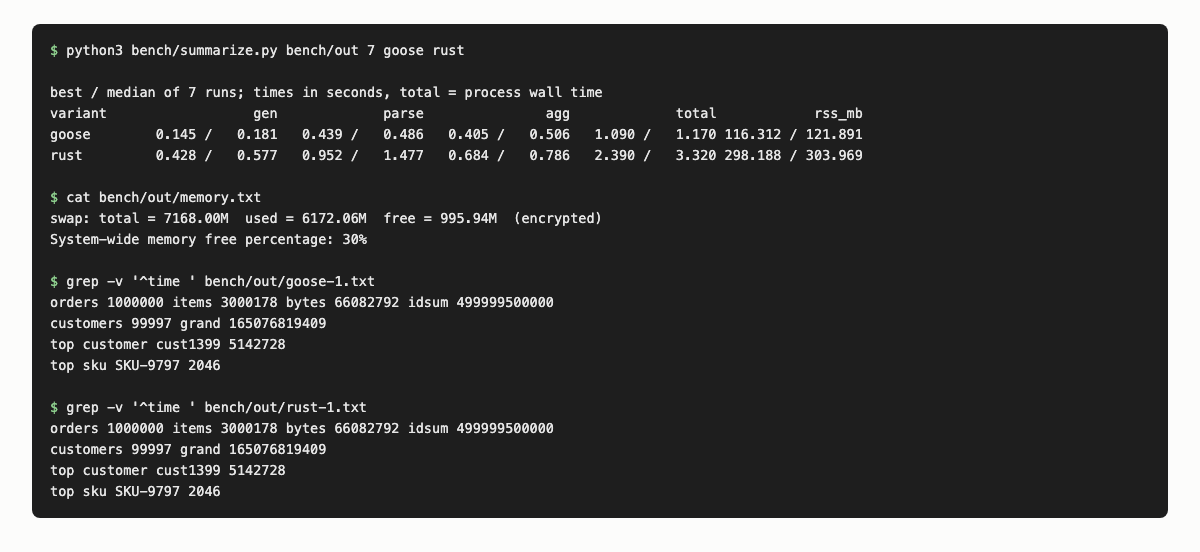
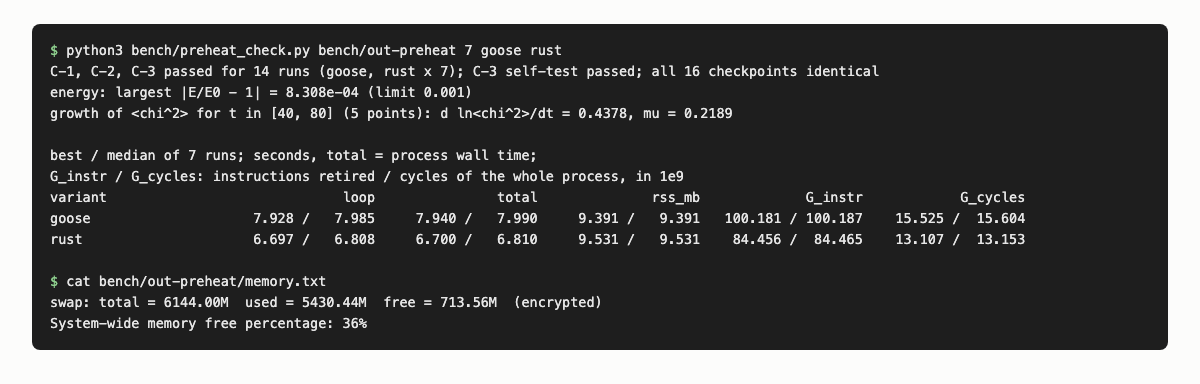
この記事の出力の画像は、画面のキャプチャではありません。計測のときに保存した生データを、goose-lab の集計スクリプト(bench/summarize.py と bench/preheat_check.py)でもう一度集計し、その出力を書き換えずに画像にしたものです(長い行の折り返しだけしています)。
この数字の注意
- 測っているとき、Mac がスワップしていました(スワップ 7168 MB のうち 6172 MB を使用。メモリーが 8 GB しかない……)。メモリーを多く使う Rust の方が損をするので、Goose に有利にゆがんでいます。どれだけゆがんだかは分かりません。Rust の解析は最良 0.95 秒、中央値 1.48 秒と、回によって大きく揺れています。比は「2〜3 倍くらい」と読んでください。
- 生成の区間は、ほとんど整数を文字列にする処理です(Goose の
format、Rust のwrite!)。データ構造が関係しないのに 3 倍の差があるので、全体の差の一部は、メモリーの持ち方ではなく、文字列にする処理の差です。 - Rust 側は「素直な書き方」です。作者が比べている「最速の安全な Rust」は、確保をまとめる書き方(アリーナ)なので、この比較では確かめていません。
寄り道:ハッシュ関数を替えたら遅くなった
Rust の標準の HashMap は SipHash で、速さより安全を取ったハッシュ関数です。比較が SipHash のせいで決まらないように、FxHash 風のハッシュ関数を手で書いた版も作りました。ところが、集計が SipHash の 2.8 倍遅くなりました。最後の掛け算のあとで下位のビットがよく混ざらず、hashbrown が表の位置に使う下位のビットが偏るためです。rustc-hash 2 と同じ最後の回転を足しても、まだ 2 倍ほど遅いままでした。
一方、SipHash のままでも集計の区間(0.26〜0.29 秒)は Goose(0.24 秒)に近かったので、ハッシュ関数は 2 つを分ける原因ではありません。この版は外しました。
比べたこと 2:preheating
次は逆に、Goose の強みが出ないと予想した計算です。題材は宇宙論の preheating にしました。
preheating とは
インフレーションが終わった直後の宇宙では、エネルギーのほとんどをインフラトンという場 が持っていて、 はポテンシャルの底のまわりで振動しています。このエネルギーがふつうの粒子に移らないと、熱いビッグバンの宇宙につながりません。preheating はこの移り方のうち、共鳴によって爆発的に進むものです。
今回使ったのは、いちばんよく知られた模型の 1 つです(Greene・Kofman・Linde・Starobinsky、1997 年。末尾の参考文献 [1])。インフラトン と、もう 1 つの場 のポテンシャルを次のように置きます。
宇宙の膨張は変数を置き換えると式から消せます。場に宇宙の大きさ を掛けて振動の初めの振幅 で割り(、 も同じように置き換え)、時間を共形時間 から に取り直します。この模型では振動する のエネルギーが放射と同じように薄まるので、置き換えで残る の項は平均すると 0 になります。この項を落とすと、解く式は平らな空間の式と同じ形になります。
ここで で、今回は です。
が小さいうちは、 は に従って、周期およそ 7.416 で振動します(楕円関数の cos です)。このとき をフーリエ成分 に分けると、各成分は次の式に従います。
を通して振動数が周期的に変わる振動子なので、パラメーター共鳴が起きます。ブランコをちょうどいいタイミングでこぐと、振れ幅がどんどん大きくなるのと同じ仕組みです。パラメーター共鳴の一般的な説明は、ランダウ=リフシッツ『力学』の §27 にあります(参考文献 [2])。特定の の帯では、振幅が指数関数的に増えます。
共鳴の強さは によって大きく変わります。論文 [1] の Fig. 4 は と ごとの成長率 の図で、その図の中のいちばん大きい値は 0.237 です。 のときの値は、論文のうち読めた範囲では見つからず、まだ確かめられていません。
が大きくなると、 に反作用して、非線形でカオス的な段階に入ります。ここは式を手で解けないので、場を格子の上に置いて、そのまま時間を進めて解きます。
格子の上での計算
- 格子:64×64×64 点、間隔 (箱の一辺 32、いちばん小さい波数 0.196)、周期境界
- ラプラシアン:隣の 6 点を使う差分。隣の番号は、表
up[i] = (i+1) % Nとdn[i] = (i+N-1) % Nを先に作って引きます(両方の言語で同じ) - 時間の進め方:リープフロッグ法(先に力で運動量を進め、次に新しい運動量で場を進める)。 で 3000 ステップ( まで)。この差分の安定の条件は なので、十分に内側です
- 初期値:、、( は格子点ごとの、−1 から 1 の一様乱数)。本来は真空のゆらぎのスペクトルで置くところを、簡単のために白色雑音にしています。そのため、物理の結果ではなく、数値計算のベンチマークとして扱います
場は 4 つの f64 の配列(、 と、それぞれの運動量)で、合わせて 8 MB です。注文のときと違って、メモリーの逼迫は効かないはずです。
計算が正しいかの確かめ方
計測のスクリプトは、毎回の実行で次の 3 つを確かめます。
- C-1:出力した数がすべて有限であること
- C-2:全エネルギーが、どの時点でも最初の値から 0.1% 以内であること
- C-3:Goose と Rust が出力した数が、どの時点でも完全に一致すること
全エネルギーは次の式で計算します(勾配は前進差分)。
C-3 は、数を 1 つだけ最後の 1 ビット(1 ulp)ずらした出力を検出できることを、毎回の実行で先に確かめています。
間違えたところ 1:エネルギーが ±3% 揺れた
最初の版では、エネルギーが 8192 のまわりで 7974 から 8444 まで、約 ±3% 揺れました。リープフロッグ法の誤差は の大きさのはずなのに、これは の大きさです。
原因は、運動量が場より半ステップ遅れていることを忘れていたことでした。初めの運動量を ではなく の値として置き、エネルギーにもそのまま使っていました。いまは次のようにしています( は運動量、 は力)。
- 初めに半ステップ戻す:
- エネルギーを計算するときだけ、場と同じ時刻の運動量を作る:(保存している状態は変えません)
間違えたところ 2:結果は一致しないはずだった
最初は「clang が -O2 で掛け算と足し算を 1 命令(FMA)にまとめるので、Goose と Rust では丸め方が変わり、結果は一致しない」と考えていました。C-3 も「 で まで一致」という緩い条件にしていました。
ところが、最初の実行で、すべての時点の数が完全に一致しました。調べてみると、Goose が生成する C のコードの先頭に #pragma clang fp contract(off) が入っていました。FMA へのまとめを、わざと止めているんです。Rust もこのまとめはしないので、ソースで同じ順番に計算すれば、IEEE 754 のもとで同じ結果になります。そこで C-3 を「完全に一致」に改めました。
preheating は途中からカオス的になるので、丸め誤差が 1 ビットでも違えば、最後は全然違う値になります。最後まで一致したことは、2 つのプログラムがまったく同じ計算をしていることの強い確認になりました。
結果
格子の計算は「同じ大きさの数がずらっと並んだ配列」を回すだけです。この形はどちらの言語でもメモリー上の姿が同じなので、Goose の強み(確保をしない、詰めて置く)が効かないはずです。予想は「だいたい同じ速さ」でした。
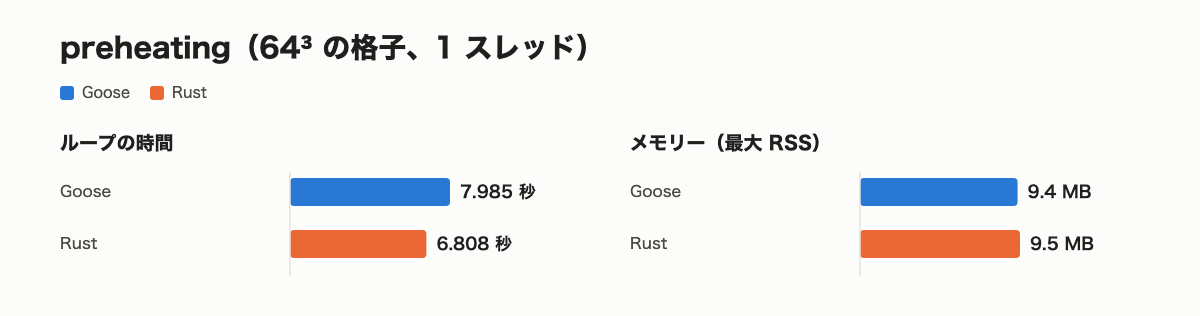
メモリーは同じで、時間は Goose の方が 17% 長くかかる、という結果でした(ループの時間の中央値が 7.985 秒と 6.808 秒、7 回)。予想は Rust 寄りに外れています。
物理としてはちゃんと動いていて、 は から増え始め、 までに 14 桁ほど増えてから頭打ちになりました( から )。
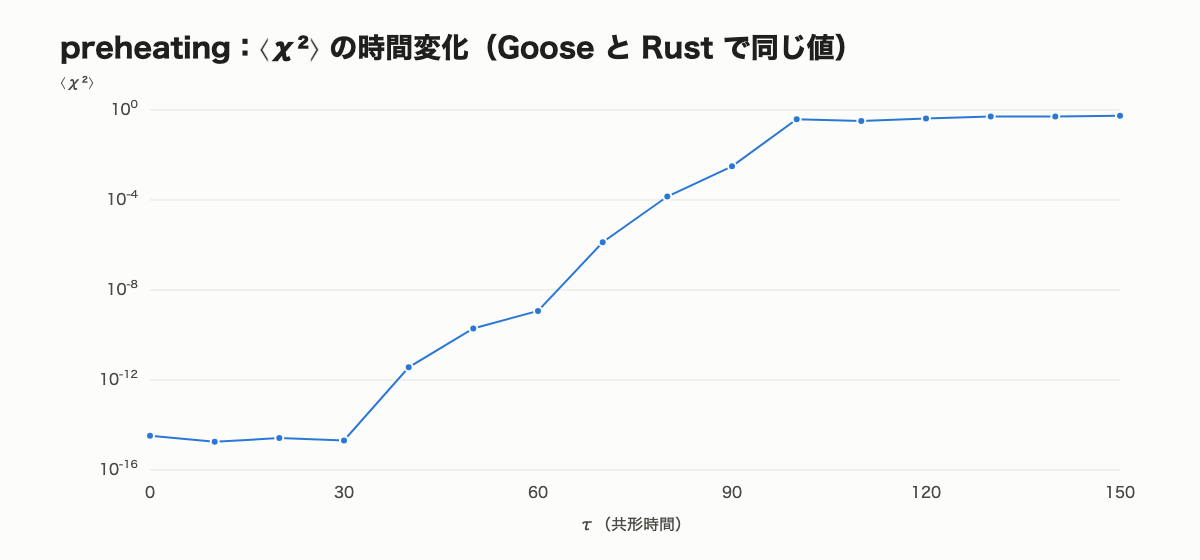
から 80 のあいだで をあてはめると、 でした。 までが平らなのは、初期値の白色雑音のうち、共鳴しない成分( の床)が、共鳴する成分の増え方を隠しているためです。最初はあてはめの範囲を から 50 にしていて、この床に気づいてから 40 から 80 に改めました。
エネルギーは最初の値から 0.1% 以内()で保たれていました。ただ、見積もりより上限に近いので、理由はまだ調べていません。
17% の差の原因
最初は「言語の設計の差かな」と思っていました。でも、機械語を見比べたら、原因は 配列の範囲チェック(境界チェック) でした。
力を計算する関数の機械語
1 つの格子点の力を計算する補助の関数 accel は、どちらの言語でも、ループから関数として呼ばれていました(objdump -d で、Goose は bl _accel_g、Rust も bl で accel を呼んでいます)。なので、インライン展開の有無は差の原因ではありません。2 つの関数の中身を比べると、次のとおりです。
- 浮動小数点の計算:Goose 26 個、Rust 26 個(同じ)
- 範囲チェック(比べて分岐する組):Goose 14 個、Rust 6 個
- 何と比べているか:Goose は実行時の配列の長さ(
f.lenとc.lenの 2 つ)、Rust は定数 262144(= 64³) - 2 つ目の戻り値:Goose はメモリーに書き込む(
str d1, [x15])、Rust はレジスター(d1)で返す
Rust(LLVM)はプログラム全体を見て「この配列はいつも 64³ の長さだ」と分かるので、隣の番号ごとに 1 回、定数と比べるだけで済んでいました。Goose は 7 つの番号を、f の長さと c の長さでそれぞれ確かめていました。どちらも、表 up・dn から引いた隣の番号が範囲の中にあることは証明できていません。Goose のコンパイラーは、プログラム全体の 54 個の範囲チェックのうち 21 個を自分で消していました(--bce-lines で表示できます)。
この差は命令の数にそのまま出ます。8 組の差 × 2 命令 × 26 万 2144 の格子点 × 3000 ステップで、約 126 億命令です。全体の差(約 157 億命令)の約 8 割を、これで説明できました。残りは、kick の中の運動量の配列のチェックと、2 つ目の戻り値の書き込みと読み込みだと思いますが、1 つずつは数えていません。
書き方を変えて命令数を数える
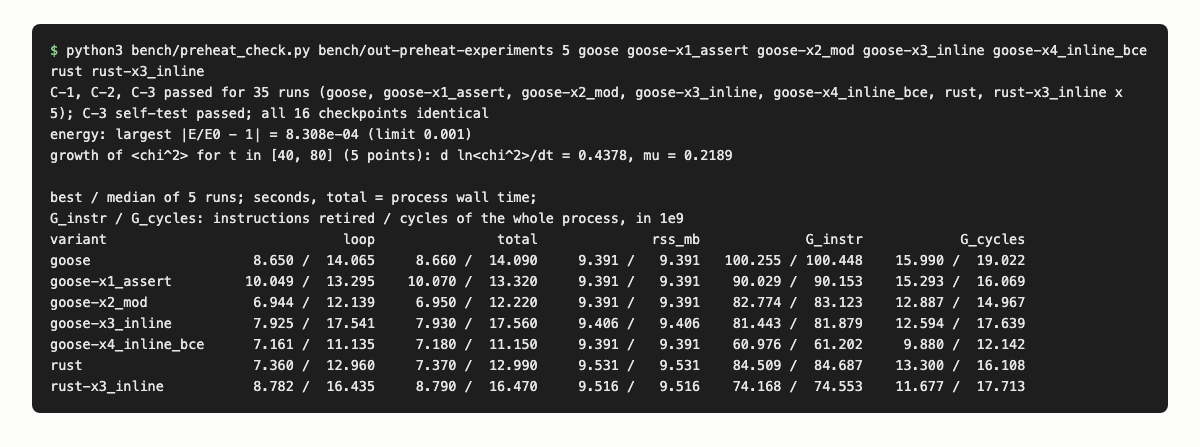
Goose のチュートリアルにある書き方に、1 つずつ直して命令数を数えました。どの版も、計算の順番は変えず、出力が完全に一致することを確かめています(すべての実行で一致しました)。
- X1:配列の長さを
assert(f.len == N³ && c.len == N³)で教える(チュートリアルが範囲チェックの解析のために勧める書き方) - X2:X1 に加えて、隣の番号を表から引かずに
(i + 1) % Nと(i + N - 1) % Nで計算する(Goose の%はユークリッド除算の余りなので、結果が 0 から N − 1 に入ると分かります) - X3:力の計算を補助の関数に分けず、ループの中に書く(Rust でも同じ書き方のプログラムを作りました)
- X4:X2 と X3 を両方
計測した時間帯はマシンの負荷が高く(8 コアに対して負荷 8.8〜10.6)、時間は回によって 2 倍も揺れました。そこで、負荷でほとんど変わらない「実行した命令の数」で比べます(5 回の最良値と中央値の差は 0.4% 以内でした)。
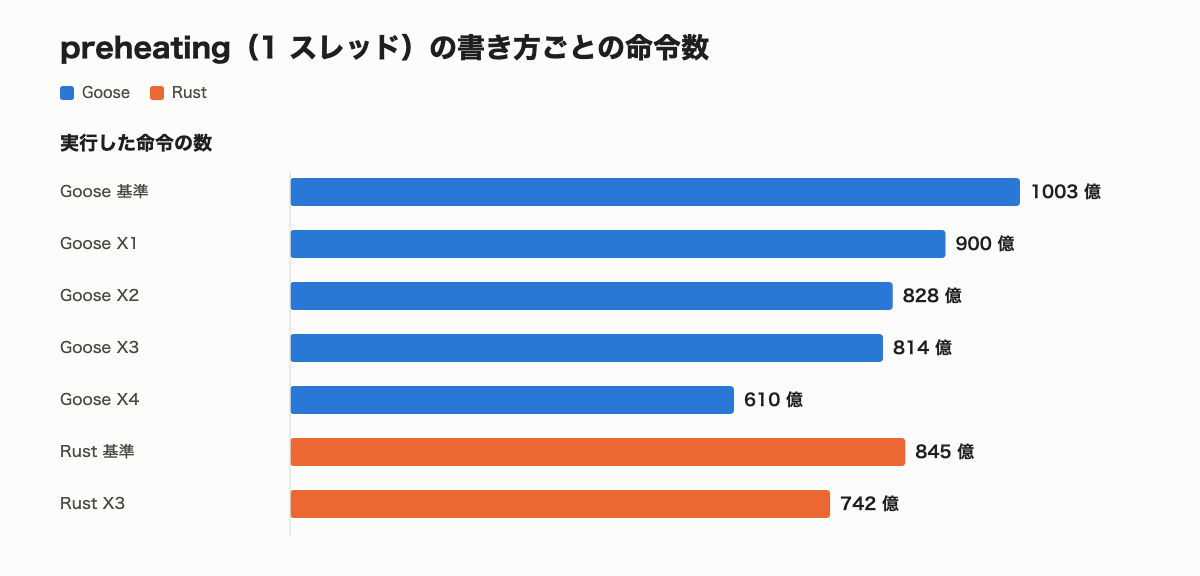
サイクル数(最良値)も同じ向きに減りました。Goose は基準 160 億から X4 の 99 億へ、Rust は基準 133 億から X3 の 117 億へです。
- 補助の関数は両方の言語で損をしていて、Goose の方が大きく損をしていました。関数をやめる(X3)と、命令数は Goose で 19%、Rust で 12% 減りました。
- チュートリアルの書き方を全部入れて関数もやめた Goose(X4)は、Rust X3 より命令数が 18%、サイクル数が 15% 少なくなりました。
- ただ、Rust X3 には同じ工夫(長さが定数の配列、
%での隣の番号)をしていないので、「Goose の方が速い」とは言えません。 - X4 でも、
kickの中に格子点あたり 8 個の範囲チェックが残りました(k 方向の隣と、χ の番号の一部)。なぜ一部だけ証明できるのかは、調べていません。
分かったのは、この 17% の差は、言語の思想ではなく、コンパイラーが範囲チェックを消せるかどうかで決まっていた、ということです。
比べたこと 3:4 スレッドにしてみた
最後に、同じ preheating を 4 スレッドで動かしました(M1 の高性能コアの数に合わせました)。ここが、2 つの言語の考え方がいちばん違うところです。どちらも標準ライブラリーだけで書き、Rust は rayon も unsafe も使っていません。
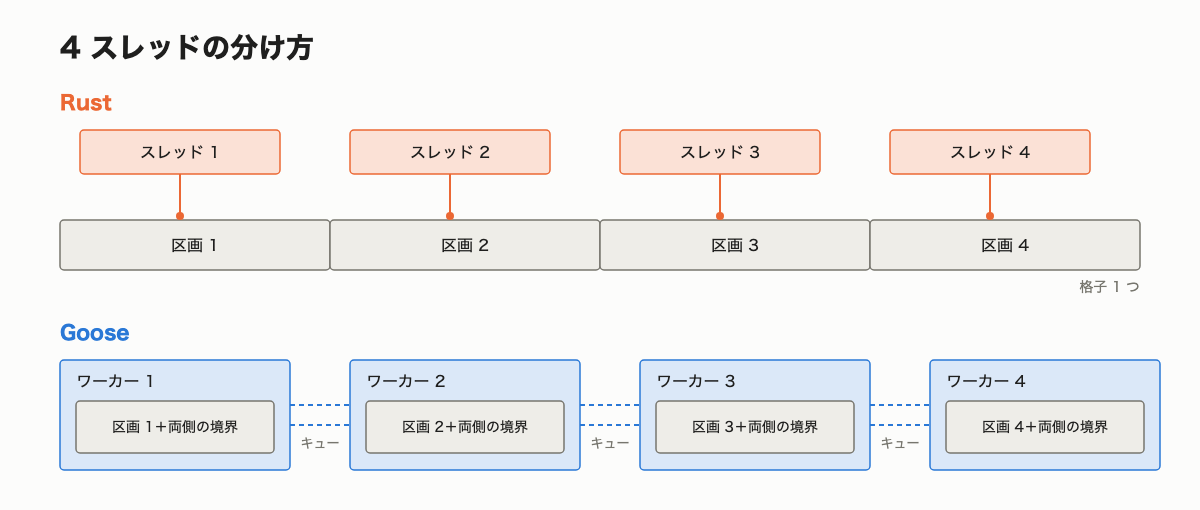
Rust:格子は 1 つ
格子を 16 面ずつ 4 つの区画に分け、各スレッドが自分の区画に直接書き込みます。1 ステップを 2 つに分けて、それぞれ std::thread::scope で 4 スレッドを起動します。
- 運動量を進める段:どのスレッドも共有の f と χ を読み、
chunks_mutで分けた自分の区画の運動量に書き込む - 場を進める段:どのスレッドも自分の区画の f と χ に書き込む
段を分けるのは、運動量を進めるときに隣の区画の場を読むからです。場を進める段と混ざると、隣がもう進めた値を読んでしまいます。2 つのスレッドが同じ区画に書き込まないことは、コンパイラーが確かめてくれます。
Goose:区画のコピーとキュー
Goose ではスレッドどうしでメモリーを共有できません。各スレッド(ワーカー)が自分の区画を最後まで持ち、両側に 1 面ずつ「隣の区画の境界の写し(ゴースト)」を持ちます。f と χ は 18 面(自分の 16 面と、両側のゴースト)、運動量は 16 面です。
毎ステップ、自分の区画の最初の面を左の隣へ、最後の面を右の隣へキューで送り、自分のキューから 2 つのゴーストの面を受け取ります。スパコンで使う MPI の「領域分割」と同じ考え方です。
Goose のキューは「型ごとに 1 本」なので、そのままでは「隣のワーカーにだけ送る」ことができません。宛先ごとに印の型(W0〜W3)を作り、GhostLo<To> のように宛先を型の引数にして、宛先ごとに別のキューにしました。さらに、下側のゴーストと上側のゴーストも別の型(GhostLo と GhostHi)にする必要がありました。受け取る側のキューが 1 本だと、1 ステップ先に進んだ隣から届いた面が混ざるからです。
途中の報告(200 ステップごと)は、1 スレッド版と同じ数にする必要があります。区画ごとの部分和を足すと、足す順番が変わって丸め方が変わるので、各ワーカーが自分の区画の写し(Snapshot)を main に送り、main が格子全体を組み立ててから、1 スレッド版と同じ順番で合計します。Rust は、main のスレッドが共有の配列をそのまま合計します。
この経路は、コンパイラーは何も確かめてくれません。印の型を間違えると、止まったまま動かなくなるか、違う面が届きます。気づけるのは、出力の照らし合わせだけです。
コードの行数は、1 スレッド版から 4 スレッド版にすると、Goose が 145 行から 246 行、Rust が 151 行から 170 行でした(wc -l)。Rust は 1 スレッド版に thread::scope と chunks_mut を足しただけですが、Goose は作りから変わります。
結果:速さは測れなかった
で、肝心の速さですが……測れませんでした。
計測を始めたとき、Mac の負荷が 8 コアに対して 14.25 もあって(ブラウザやら何やら)、1 スレッド版の時間は最良値で Goose 27.7 秒、Rust 17.9 秒でした。同じ日の空いていたときの 8.0 秒と 6.8 秒と比べて、2.5〜3.5 倍です。中央値は最良値の約 2 倍(Goose)と約 4.5 倍(Rust)でした。空いているコアがないので、4 スレッドにしても速くなりようがありません。
それでも、分かったことはありました。
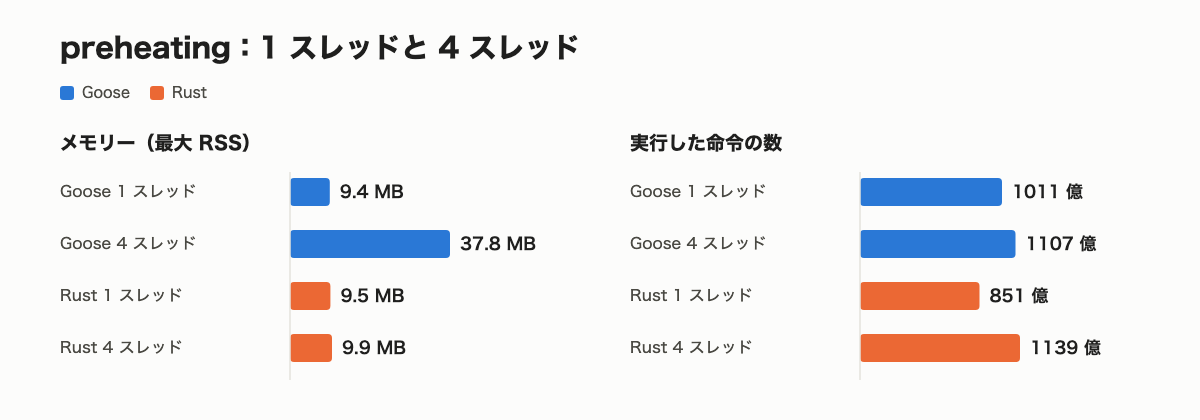
メモリーは 5 回の中央値、命令数は 5 回のうち最も少ない値です(命令数はすべてのスレッドの合計です)。
- 正しさ:4 スレッド版は両方とも 1 スレッド版と最後の桁まで同じ結果になりました。カオス的な段階も含めてです。Goose では、ゴーストの面が正しいワーカーに、正しいステップで届いていることの確認にもなりました。
- メモリー:Goose の 4 スレッド版は 1 スレッド版の 4 倍(9.4 MB から 37.8 MB)使いました。各ワーカーがゴーストつきの区画を持ち、main は報告のために格子全体を持ち、メッセージはすべてコピーです(ゴーストの面 1 つが 64 KB、区画の写しが 2 MB)。ワーカーごとにデータスタックも確保します。37.8 MB の内訳は調べていません。Rust はほぼ変わりません(9.5 MB から 9.9 MB)。
- 余分な仕事(命令数):Goose は +9.5%(1011 億から 1107 億。メッセージのコピー)、Rust は +34%(851 億から 1139 億)でした。Rust の方は、1 ステップに 2 回、4 スレッドを起動しているので、全部で 24,000 回スレッドを作っています。これが原因だと思いますが、まだ確かめていません。スレッドを 1 回だけ起動する版(スレッドプールや
std::sync::Barrier)を作れば確かめられます。 - サイクル数の増え方(Goose +36%、Rust +87%)は、命令数の増え方より大きくなりました。ただ、ここまで混んだマシンでは、サイクル数にメモリーや共有のキャッシュの待ちも入るので、これ以上は比べていません。
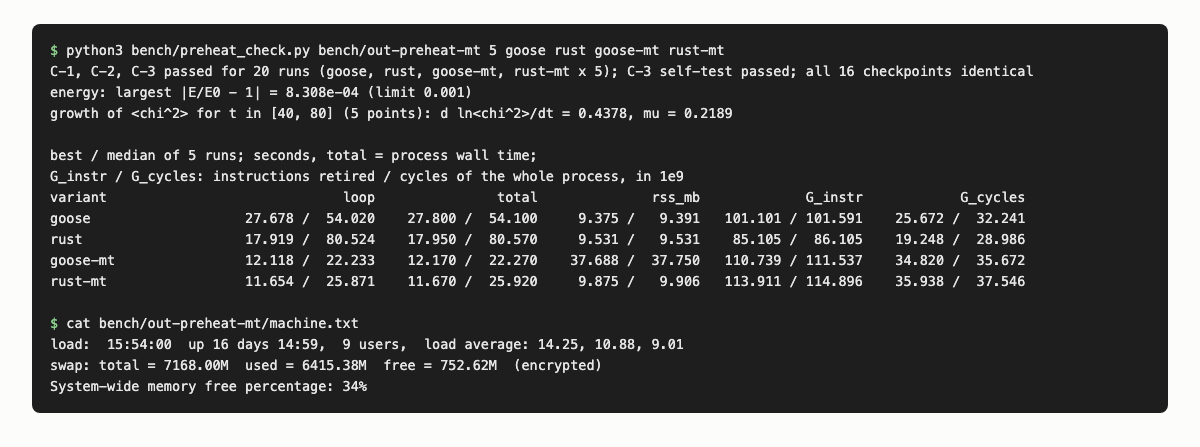
出力の最後の行が、計測を始めたときのマシンの状態です。
比べてみて分かったこと
- 大きさがばらばらのデータを大量に扱う計算(注文、木、グラフ、カタログの集計など)では、Rust の素直な書き方より明らかに速く、メモリーも少なく済みました。
- 平らな数値配列の計算(格子シミュレーションなど)では、メモリーは同じで、速さはコンパイラーの細かい事情(範囲チェック)で決まりました。
- 並列化は Rust の方がずっと楽です。Goose はデータ競合が起きない代わりに、MPI 風の通信を自分で組む必要があり、その経路はコンパイラーが確かめてくれません。
- 生成される C に
fp contract(off)が入っているおかげで、Goose と Rust の結果がビット単位で一致しました。「並列化しても答えが 1 ビットも変わらないこと」を、そのまま正しさの確認に使えたのは大きかったです。
出たばかりの言語なので、ライブラリも少なく、仕様もまだ変わりそうです。でも、「ヒープをなくす」という一点で、ここまで振る舞いが変わるのは面白い体験でした。
次にやること
- Mac が空いているときに、注文の集計と 4 スレッドを測り直す
- 確保をまとめた Rust(アリーナ)と比べて、作者の「最速の安全な Rust より 1.15 倍速い」を確かめる
- Rust のスレッドを 1 回だけ起動する版を作って、+34% のうちどれだけがスレッドの起動かを確かめる
参考文献(2026-10-29 に確認)
- [1] P. Greene, L. Kofman, A. Linde, A. Starobinsky, “Structure of Resonance in Preheating after Inflation”, Phys. Rev. D 56, 6175–6192 (1997)。arXiv、DOI
- [2] L. D. Landau, E. M. Lifshitz, “Mechanics” (Course of Theoretical Physics, Vol. 1), 3rd ed., Pergamon Press (1976)。§27 Parametric resonance(80 ページ)。出版社のページ
参考
- この記事のコードと計測の記録(英語):goose-lab
- 計測の記録:注文の集計、preheating(1 スレッド)、preheating(4 スレッド)
- preheating のプログラム:Goose の 1 スレッド版、Goose の 4 スレッド版、Rust の 1 スレッド版、Rust の 4 スレッド版
- Goose のリポジトリ
- Goose のサイト・チュートリアル
- 作者のベンチマーク